

做 GEO 優化的人多半從改寫內容開始,這一步其實排在第二。
網站前面那層 CDN 或安全外掛,可能在你沒留意的情況下擋住 AI 爬蟲,而你自己寫的 robots.txt 是乾淨的。
要確認只需要兩個步驟,三十秒做得完,做法寫在最後一節。
2026-09-17 更新:Cloudflare 於 9 月 15 日改版 AI 爬蟲設定,訓練類新增「Disallow」選項,既有網站的設定自動轉換。本文三種情況的第一、第三種、三十秒自檢的 2A 與常見問題第一題,已依官方公告與 Google 文件更正〔8〕〔9〕。
2026 年 8 月 14 號,Reddit 從 ChatGPT 的答案裡消失
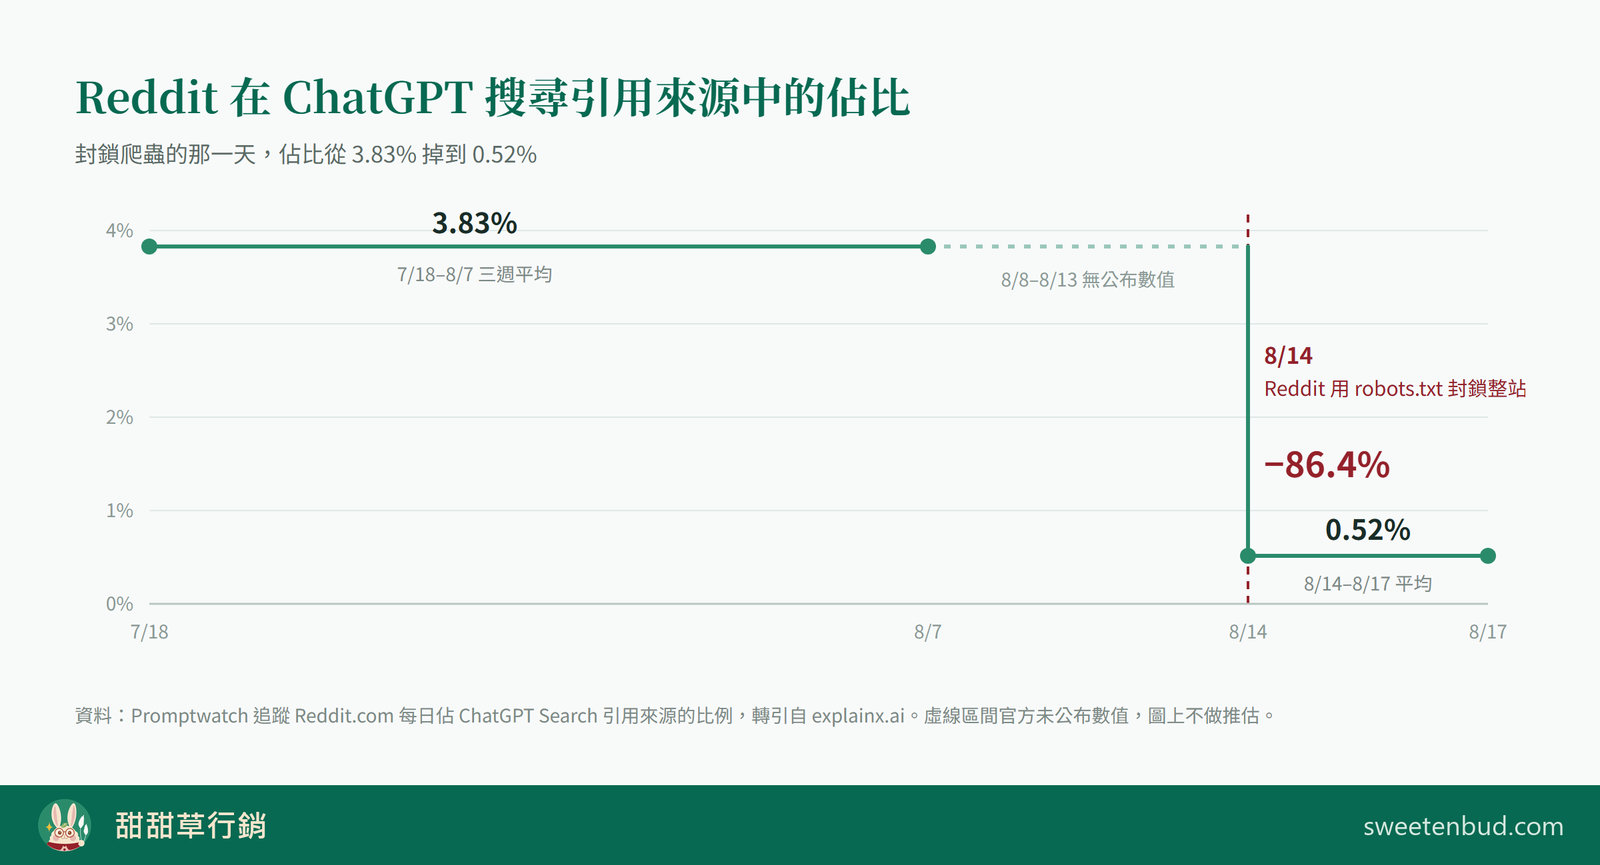
GEO 分析公司 Promptwatch 追蹤 Reddit 在 ChatGPT 搜尋引用來源中的每日佔比,7 月 18 日到 8 月 7 日之間穩定在 3.83%。8 月 14 日當天跌破 1%,8 月 14 日到 17 日的平均只剩 0.52%,相對降幅 86.4%〔1〕。
原因在 8 月 20 日揭曉:Reddit 自己在 robots.txt 把整個網域對爬蟲關掉了〔1〕。
Reddit 封鎖爬蟲是商業決定:把內容從免費管道抽回來,才有籌碼跟 AI 公司談授權金。但是多數網站不是自己選的。同一件事發生在中小企業或是個人工作室時,不會有崩跌數據給你看,你只會發現詢問度慢慢變低,然後歸咎於淡季。
GEO 優化是什麼,第一關又是什麼
SEO 是讓你的網頁排進 Google 的搜尋結果,GEO(生成式引擎優化)是讓 ChatGPT、Perplexity、Google AI 摘要這類生成式工具在回答問題時引用你。還有人用 AEO(答案引擎優化)這個詞。SEO、GEO、AEO 這三個詞的實際做法高度重疊,差別只在你在意的是搜尋結果的排名位置,還是 AI 答案裡的那行來源連結。
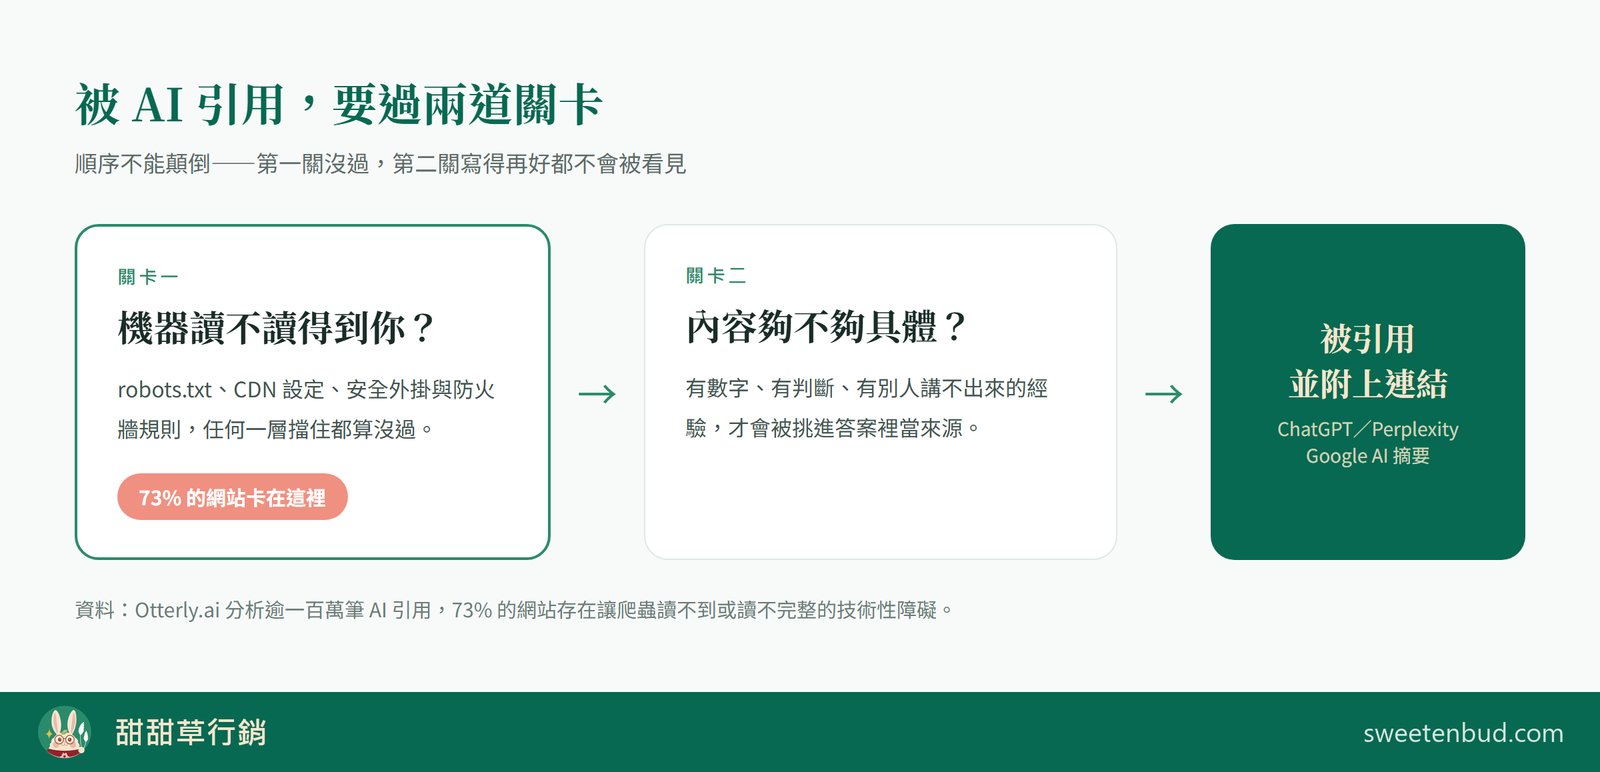
不管用哪個縮寫,被引用都要先過兩道關卡。第一關是機器能不能讀到你的頁面,第二關才是內容夠不夠好、夠不夠具體。這兩關的順序不能顛倒,因為第一關沒過,第二關寫得再好都不會被看見。
多數人一聽到 GEO 優化就直接跳到第二關,開始改寫文章、補問答、加結構化資料。Otterly.ai 分析超過一百萬筆 AI 引用資料,發現 73% 的網站有技術性障礙,讓 AI 爬蟲讀不到、或讀不完整〔2〕。換句話說,每四個網站有三個在第一關就出局,而站主完全不知道。GEO 優化的第一關不是寫作題,是設定題。
被 AI 引用,要過兩道關卡
順序不能顛倒——第一關沒過,第二關寫得再好都不會被看見
關卡一
機器讀不讀得到你?
robots.txt、CDN 設定、安全外掛與防火牆規則,任何一層擋住都算沒過。
73% 的網站卡在這裡
關卡二
內容夠不夠具體?
有數字、有判斷、有別人講不出來的經驗,才會被挑進答案裡當來源。
被引用並附上連結
ChatGPT/Perplexity
Google AI 摘要
資料:Otterly.ai 分析逾一百萬筆 AI 引用,73% 的網站存在讓爬蟲讀不到或讀不完整的技術性障礙。
誰幫你把 AI 擋掉了:三種真實情況
誰把 AI 擋掉了:三種真實情況
共通點是它們都不會通知你,你只會發現詢問度慢慢變低
1
Cloudflare 訓練類選到「封鎖」
名字聽起來只擋訓練,但 9 月 15 日起,同時做搜尋的 Googlebot 也會被整隻擋掉。
後果:幫你把讀者送回來的那一種也被關了
2
安全外掛或防火牆規則
擋的是爬蟲的身分而不是路徑,請求在讀到 robots.txt 之前就被攔下來。
後果:robots.txt 乾乾淨淨,其實進不來
3
9 月 15 日起多了「Disallow」
它不擋 Googlebot 搜尋,但會替你關掉 Google-Extended,Gemini 就不再引用你的頁面。
後果:開過舊開關的網站,已被自動轉成這個選項
一、Cloudflare 訓練類的「封鎖」選項
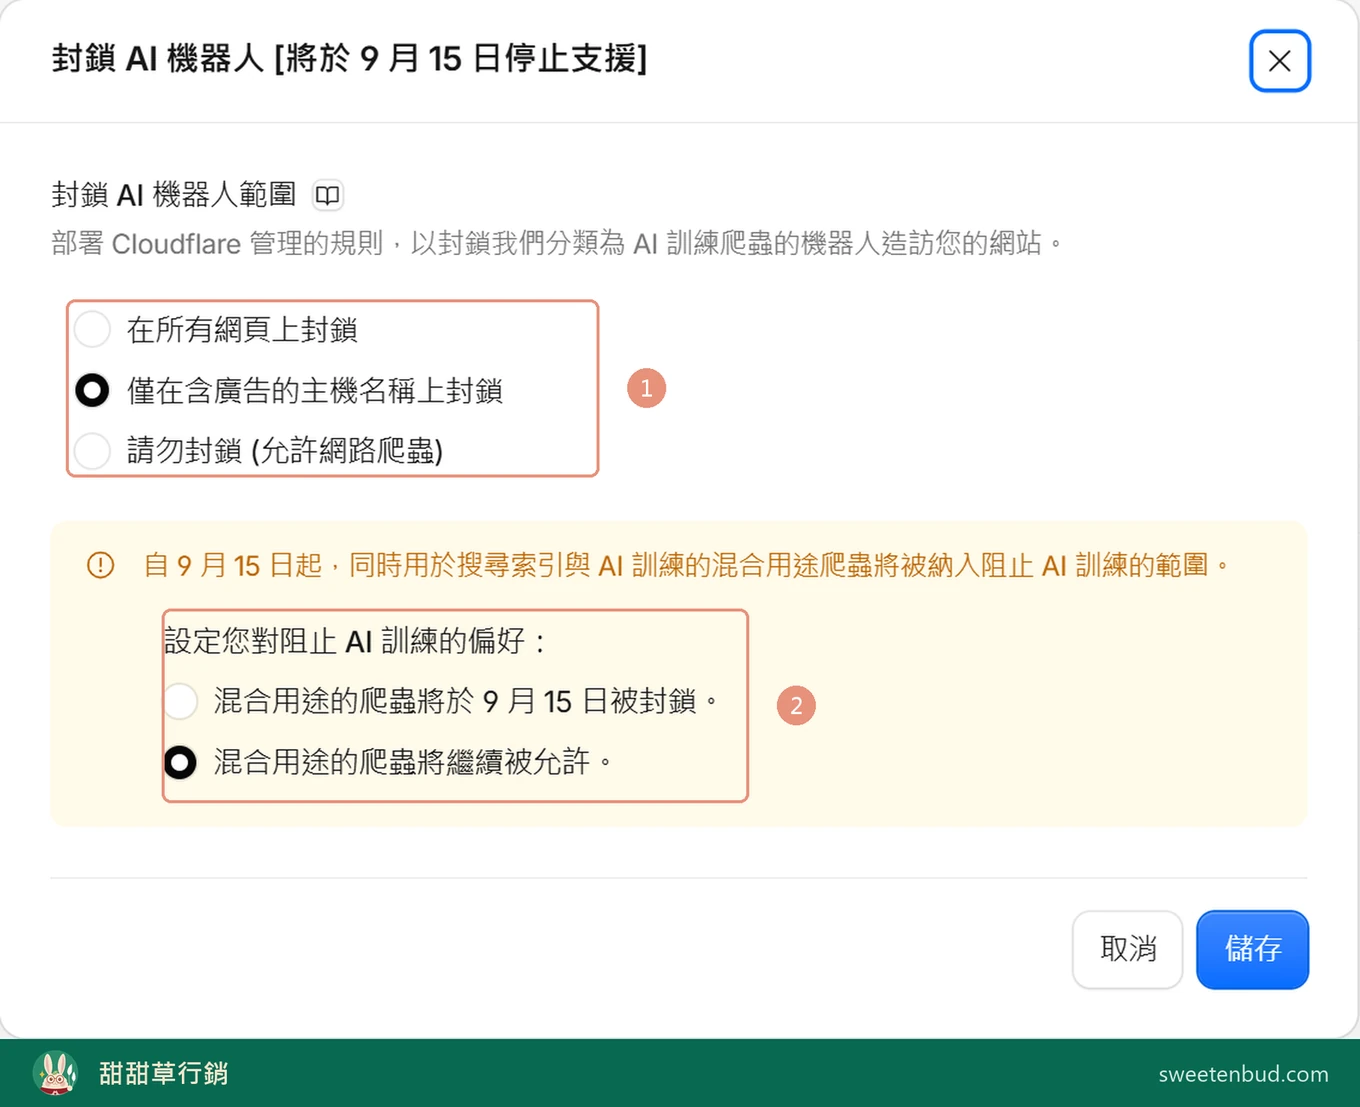
Cloudflare 後台的「設定 AI 機器人政策」把 AI 爬蟲分成搜尋、代理、訓練三類,訓練那一格有一個選項叫「封鎖」〔3〕。很多人選它,是因為看到「AI 會抓走你的內容」的新聞,覺得防一下比較安心。
問題在於它擋的範圍比名字聽起來大。GPTBot 這類是訓練型,把你的內容抓回去餵模型;OAI-SearchBot 這類是檢索型,使用者當下問了問題,它才去讀你的頁面、然後在答案裡附上你的連結。還有第三種:有些爬蟲同時做搜尋與訓練,Cloudflare 稱為混合用途爬蟲,點名的是 Googlebot、Applebot 和 Bingbot〔4〕。Cloudflare 是看身分擋人的門衛,Googlebot 走進來時,它分不出這一趟是來搜尋還是來訓練。所以 9 月 15 日起,訓練類選「封鎖」,Googlebot 會被整隻擋掉;選「在含廣告的頁面上封鎖」,則在有廣告的頁面上被擋掉〔8〕。你以為只關掉了訓練型,Google 一般搜尋的爬蟲也一起關了。
那 9 月 15 日以前的舊開關「封鎖 AI 機器人」呢?它已經停用,開過它的網站會被自動轉成新版設定,Google 搜尋照常進得來〔8〕。轉成什麼、要不要回後台看,第三種情況會說明。
二、安全外掛或防火牆擋掉爬蟲身分
第二種更難發現。robots.txt 看起來乾乾淨淨,但是請求還沒走到你的網站,就被前面的防火牆規則攔下來了,因為擋的是 User-Agent 而不是路徑。這一層在 robots.txt 上完全看不出來。
想自己假冒爬蟲身分敲門測試的人要先知道一件事:Cloudflare 會用 IP 反查驗證真假 bot,假冒者一律被擋在門外(回 403),連假冒 Googlebot 都照擋。所以這個測試只能證明一半:頁面正常出現(回 200),表示這一層確實沒擋你;被擋下來(回 403),可能是它真的擋 AI 爬蟲,也可能只是識破你在假冒,分不出來。我們九月初就因為這個誤判過兩個客戶站,以為人家封鎖了 AI 爬蟲,其實只是我們的假身分被識破。
三、9 月 15 日起,訓練類多了一個「Disallow」
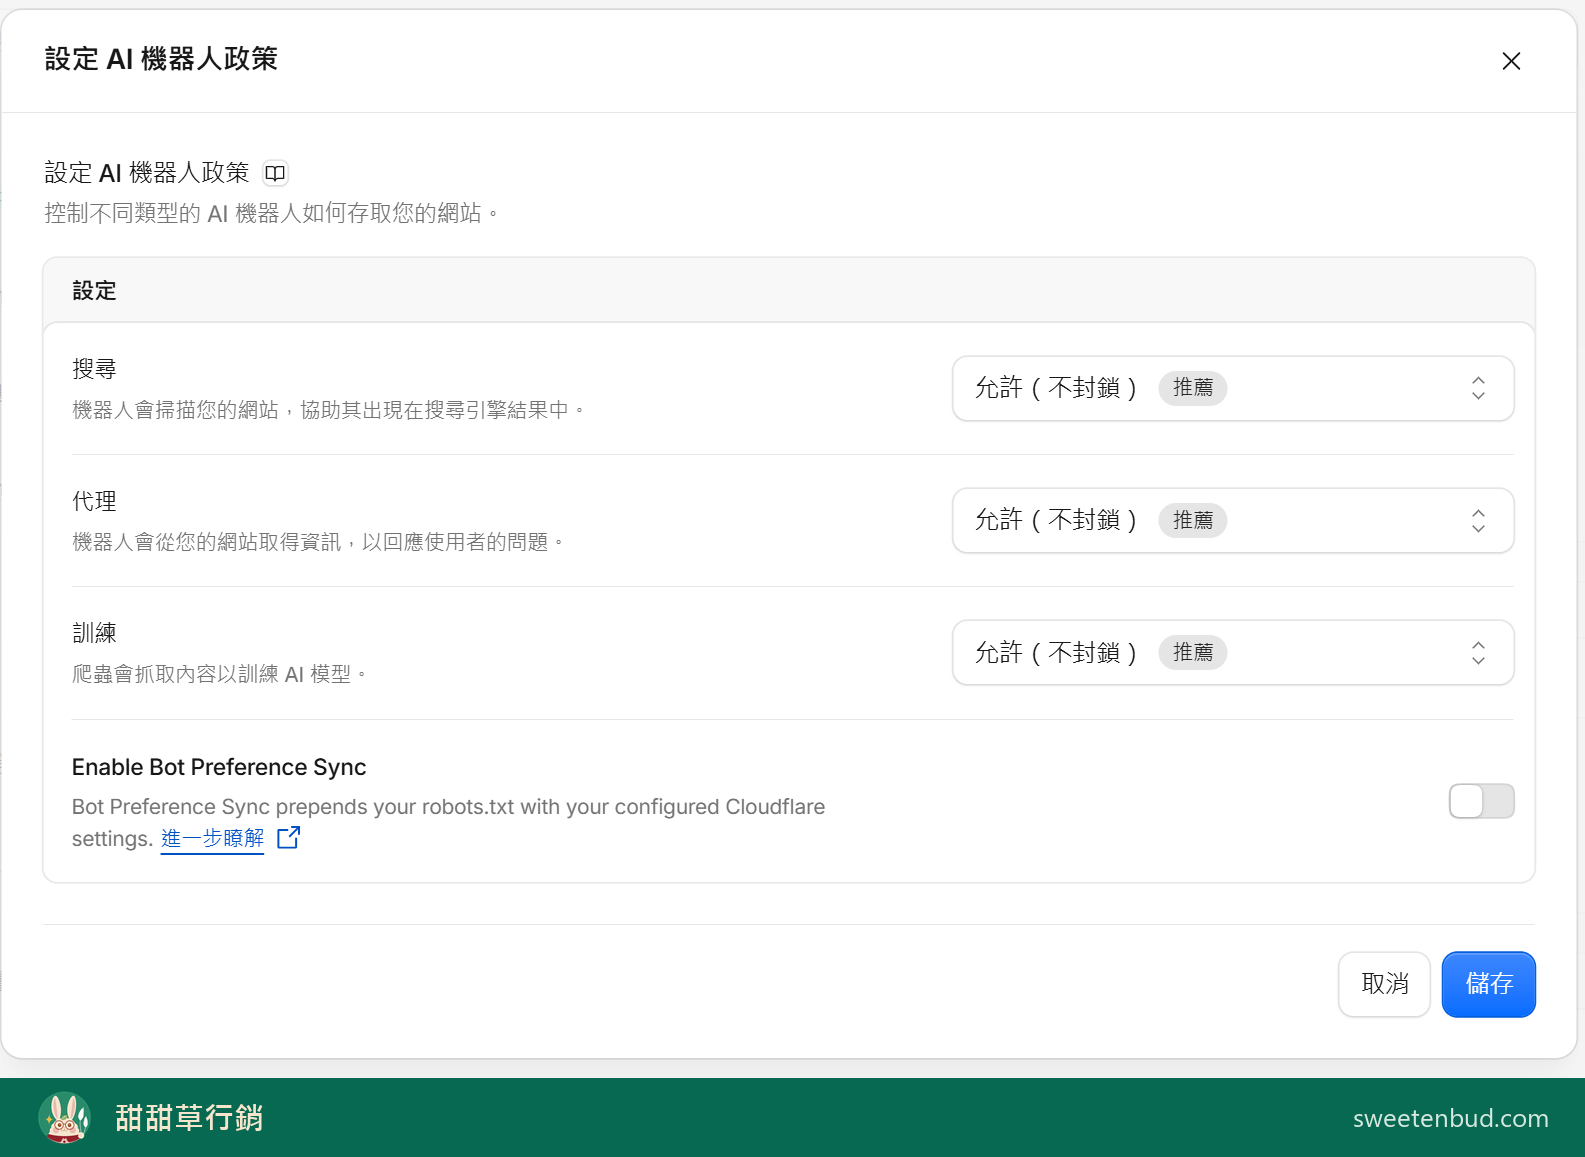
這一節講的還是 Cloudflare 的設定。2026 年 9 月 15 日起,Cloudflare 把 AI 爬蟲分成三類,各自決定要不要放行〔3〕〔5〕。搜尋類幫你的內容出現在搜尋結果裡;代理類在使用者發問的當下來讀你的頁面;訓練類把內容抓回去教 AI。每一類都可以選「封鎖」、「在含廣告的頁面上封鎖」或「允許(不封鎖)」,訓練類另外多一個「Disallow」〔8〕。
「Disallow」是 9 月 15 日新加的選項,意思是 Google 照常來做搜尋,但內容不准拿去訓練。它的做法是替你在 robots.txt 寫一行字,告訴 Google 專門負責訓練的 Google-Extended 不要來〔8〕〔9〕,而且要把面板最下方的 Bot Preference Sync 打開,這行字才會真的寫進去〔10〕。聽起來兩全其美,但有一個代價:Google 官方文件寫明,這一行字也會讓 Gemini 不再引用你的頁面〔9〕。靠內容把人帶進來的網站,等於少了一個曝光管道,所以我們不建議選它。
已經在用 Cloudflare 的網站,官方說不用做任何事,設定會自動轉換〔8〕。從來沒動過設定的,三格維持允許;開過舊開關的,訓練那格會被轉成「Disallow」。我們管理的一個網站就是這樣被轉過去的,回後台看一眼、改回允許,前後不到一分鐘。
新加入 Cloudflare 的網域,沒放廣告的三格都推薦允許;有放廣告的,訓練推薦「Disallow」,代理推薦「在含廣告的頁面上封鎖」〔8〕。「在含廣告的頁面上封鎖」不是整站封鎖,Cloudflare 會自己偵測哪些頁面有顯示廣告,只擋那些頁面〔3〕。多數的事務所網站、品牌官網、企業形象網站沒有掛廣告,這個選項擋不到任何東西,看到「封鎖」兩個字先不用緊張。有掛 Google AdSense 或聯播網廣告的網站才要注意,那些頁面上的 Googlebot 會真的被擋住。
該擋還是該開,看你靠什麼賺錢
靠內容本身收費的(新聞媒體、付費專欄、圖庫、線上課程)擋得有道理,因為 AI 把答案摘完,讀者就沒有理由付費了。Reddit 屬於這一派的極端版本。
靠內容把人帶進來詢價的,情況完全相反。設計、顧問、醫療、法律、地方服務這些行業,內容的功能是證明你懂,成交發生在對話裡而不是文章裡。擋掉 AI 等於把招牌收進倉庫,還要付倉庫租金。
對應到 Cloudflare 的設定就是兩條路。靠內容把人帶進來詢價的,三格全部允許,不用再想。靠內容本身收費、確定要擋訓練的,訓練那格選「Disallow」,Google 搜尋照常,Gemini 的引用就放掉。
我們實際查了五個網站的 robots.txt
五個網站查下來,沒有一個把 AI 爬蟲擋掉。真正會擋掉爬蟲的,是掛在 Cloudflare 後面、或裝了安全外掛與防火牆的網站。
查的是一個律師事務所網站、一家製鞋廠、一家 B2B 公司的兩個網域,加上我們自己的官網。六隻爬蟲逐一比對:GPTBot、ClaudeBot、PerplexityBot、OAI-SearchBot、Google-Extended、Applebot-Extended。
五個站都沒有擋任何一隻。唯一有寫封鎖規則的那個站,擋的是 Baiduspider、AhrefsBot、SemrushBot 這類 SEO 工具爬蟲,跟 AI 無關,通常是前一手工程師為了省頻寬留下來的。
我們另外對其中兩個站做了 CDN 層測試,各用兩種爬蟲身分敲一次,四次都順利拿到完整檔案(回 HTTP 200)。
三十秒自檢,兩個步驟
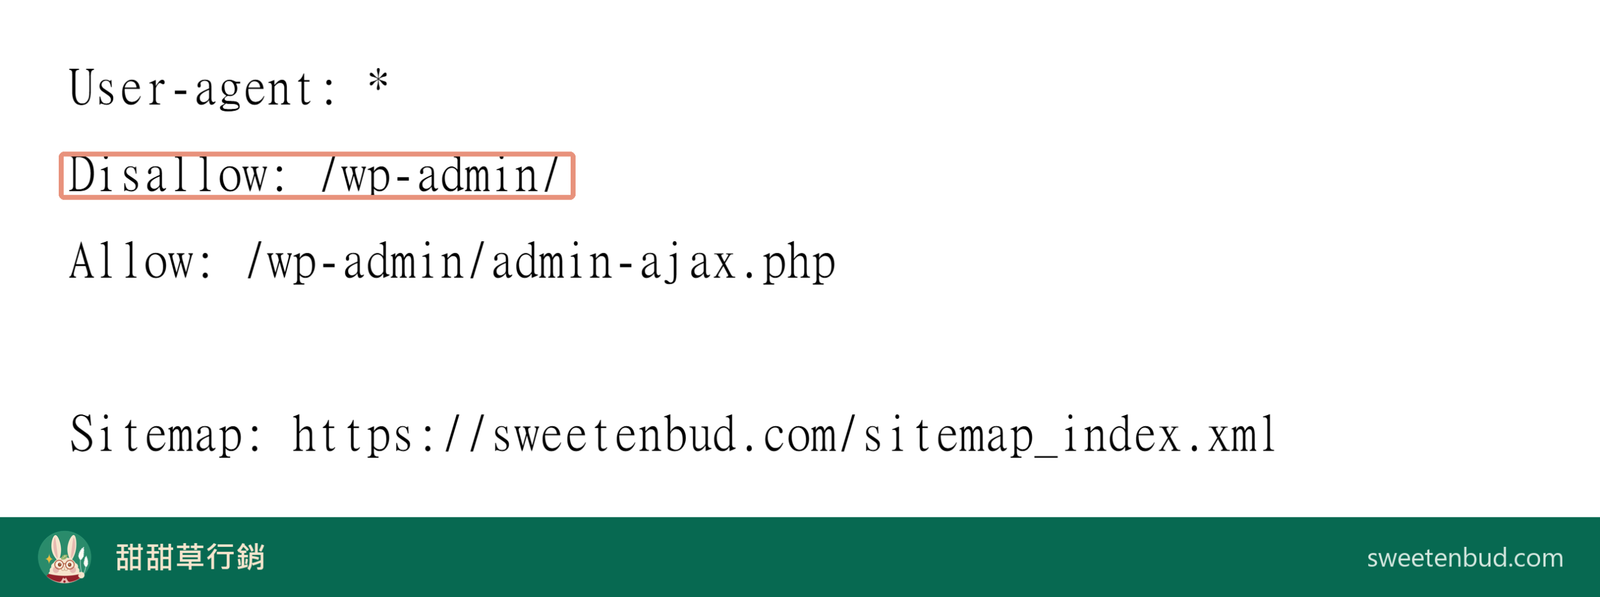
步驟一:在你的網址後面加上 /robots.txt,直接用瀏覽器打開。找有沒有 Disallow: / 出現在上面那六隻爬蟲名字底下。整份檔案通常不到二十行,看得完。
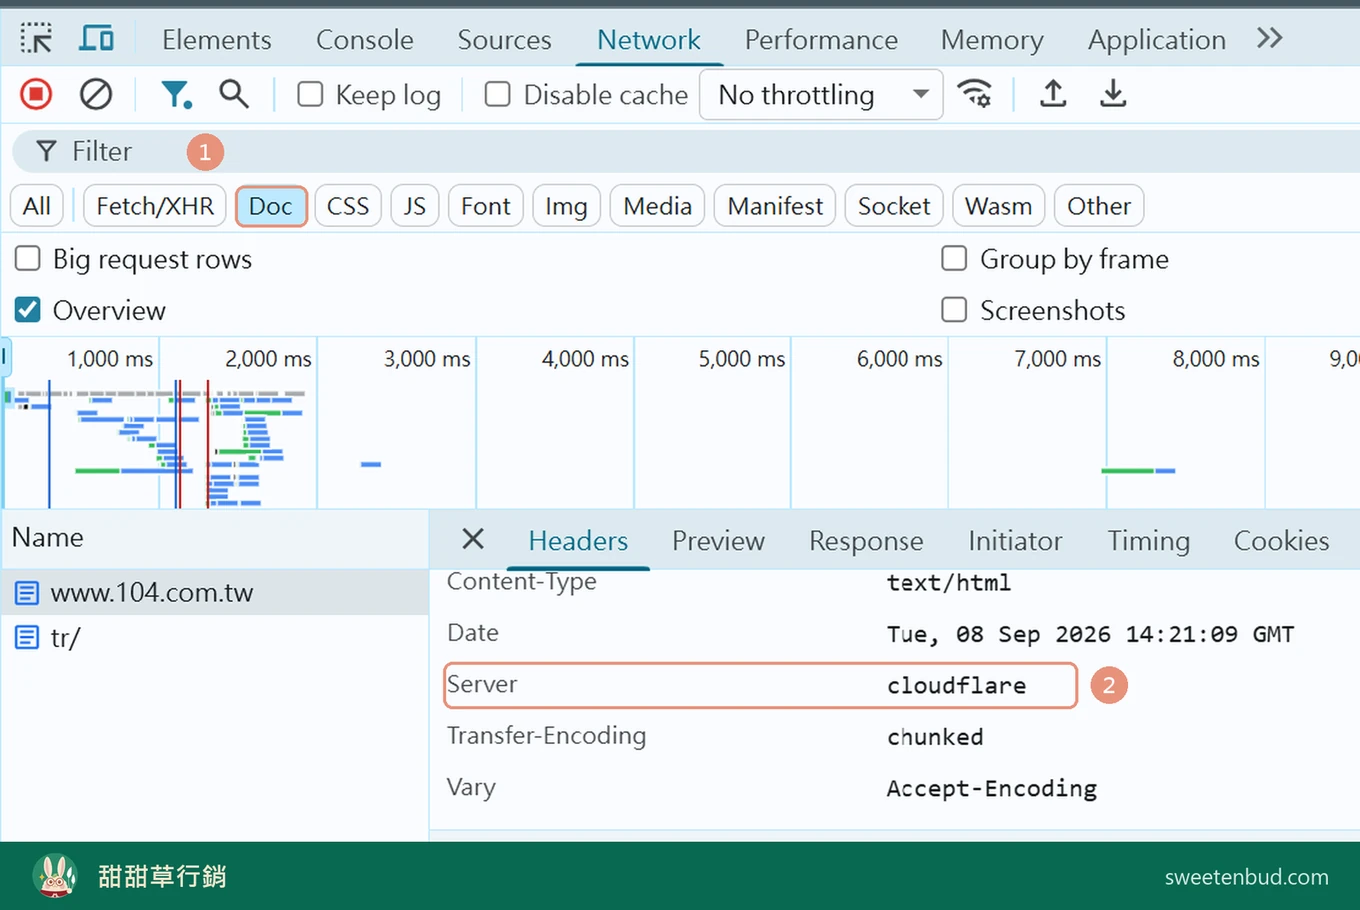
步驟二:確認你的網站前面那一層。先看你在不在 Cloudflare——這一步只對掛在 Cloudflare 後面的網站有用,而多數人不知道自己的網站算不算。最快的方法是問當初幫你架站的人,網站要掛上 Cloudflare 必須有人主動去改網域的名稱伺服器,那不是會自己發生的事。
想自己確認的話,用 Chrome 打開你的網站,按 F12 叫出開發者工具,切到 Network 分頁,然後按 F5 重新整理一次。清單上方有一排篩選鈕(All、Fetch/XHR、Doc、CSS⋯⋯),點「Doc」,清單就只剩網頁本身那一列——這一步不能省,整份清單通常有上百個檔案,捲動過就找不到它了。點那一列,右邊切到 Headers,往下捲到 Response Headers 那一段,找 server 那一行。寫著 cloudflare 就是掛在 Cloudflare 上,寫著別的名字就不是。以前面查的那五個網站為例,四個回傳 cloudflare,一個回傳 hcdn,代表是它主機商自己的 CDN。
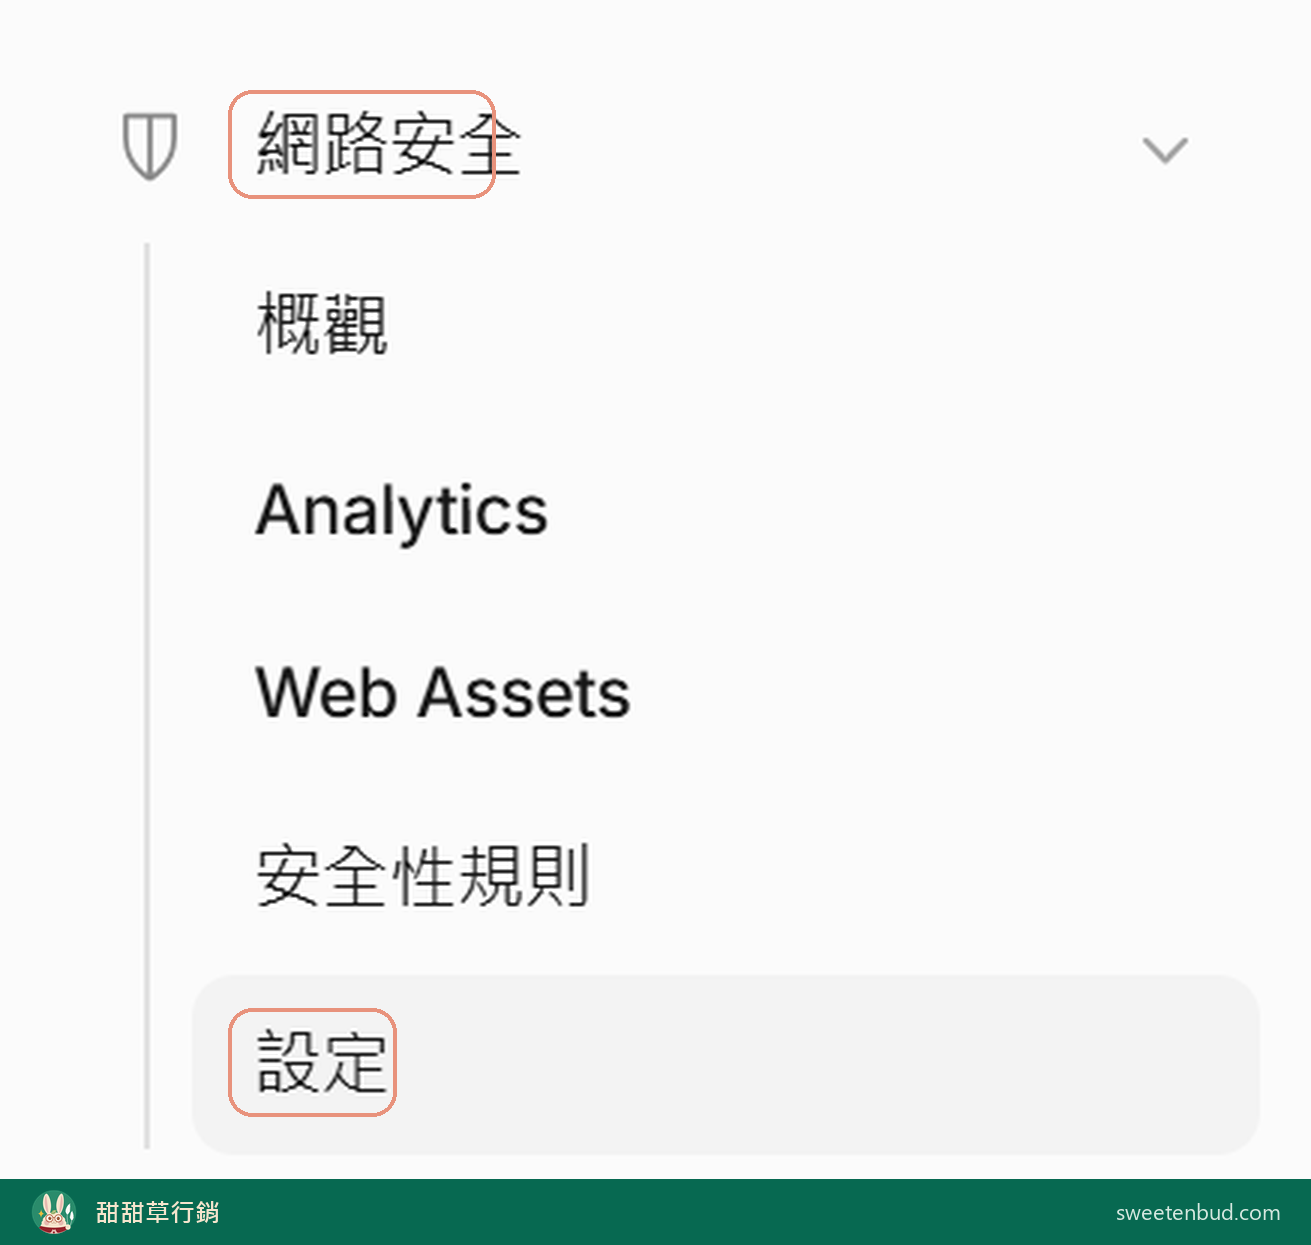
掛在 Cloudflare 的話,登入之後先從左側的「網域」點進你的網站,這一步很容易漏掉。AI 爬蟲的設定屬於單一網域,停在帳戶首頁怎麼找都找不到。
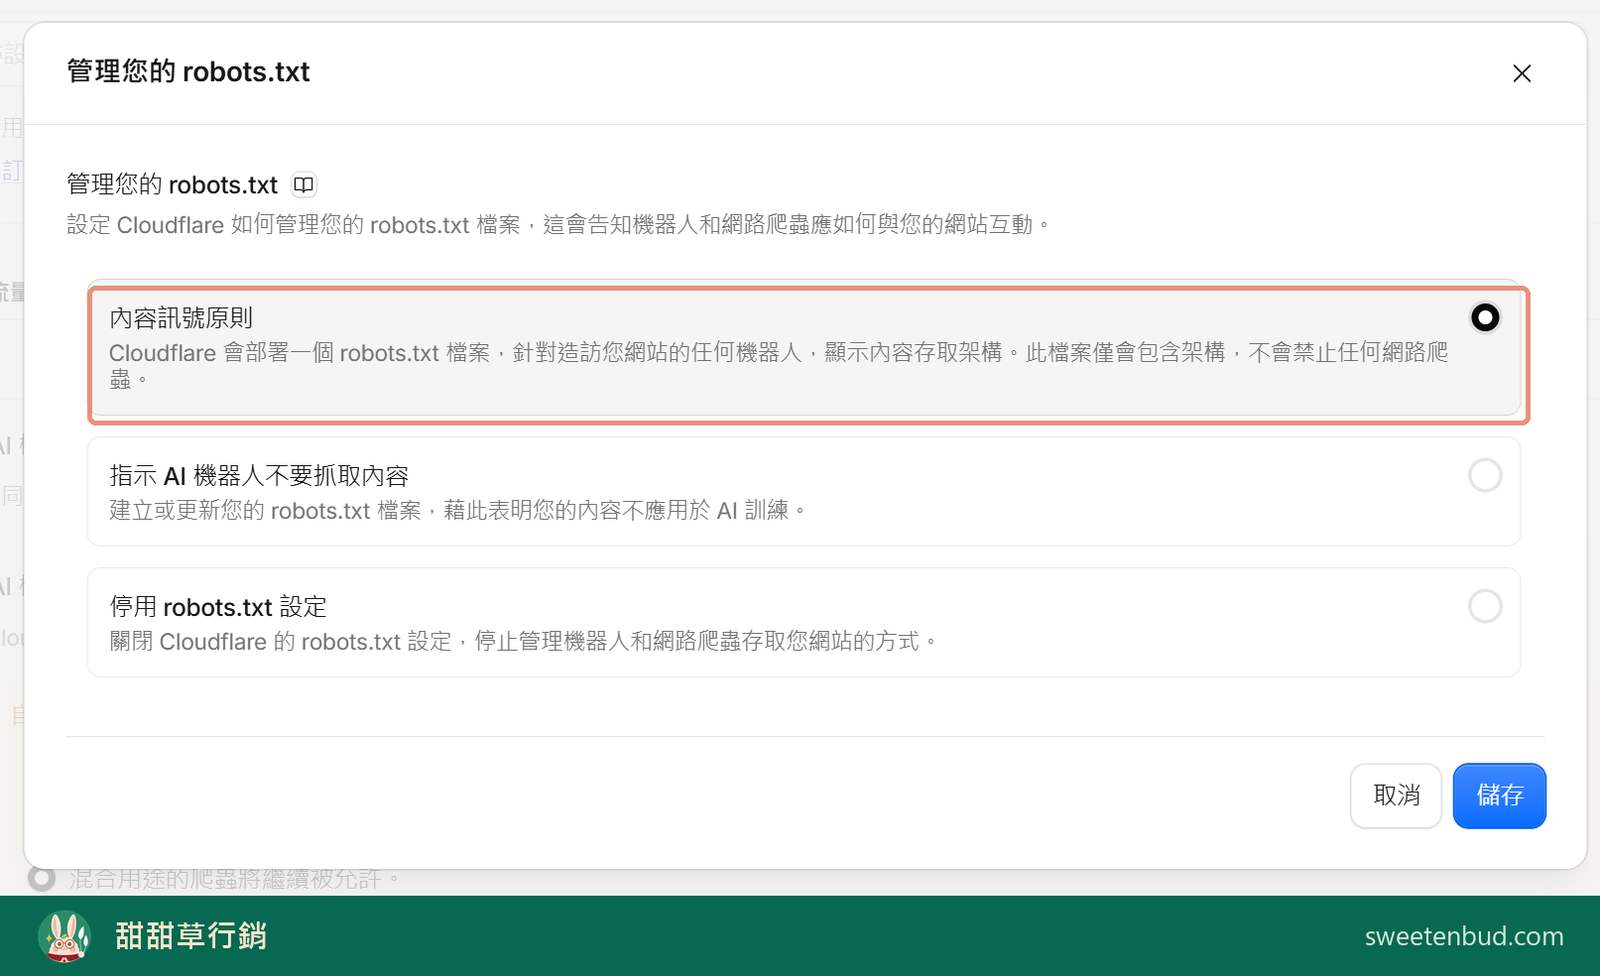
進去之後走「網路安全」→「設定」,往下捲到「機器人流量」那一區。新版的項目叫設定 AI 機器人政策,點開就是前面說的三類各自設定;舊帳號可能還看得到封鎖 AI 機器人,它旁邊已經標了「已淘汰」與停止支援日期。同一區還有一個項目叫「管理您的 robots.txt」,Cloudflare 可以幫你部署或修改這份檔案。點開有三個選項,預設是「內容訊號原則」——它只加上內容存取的說明,不會禁止任何爬蟲;另外兩個是「指示 AI 機器人不要抓取內容」與「停用」。我們實測掛在 Cloudflare 的那個站,維持預設值的情況下,robots.txt 拿到的就是網站自己那一份,沒有被改寫。Cloudflare 9 月 15 日公告,這個項目會被新面板裡的 Bot Preference Sync 取代〔8〕,介面正在陸續更新,你看到的畫面可能跟下圖不同。
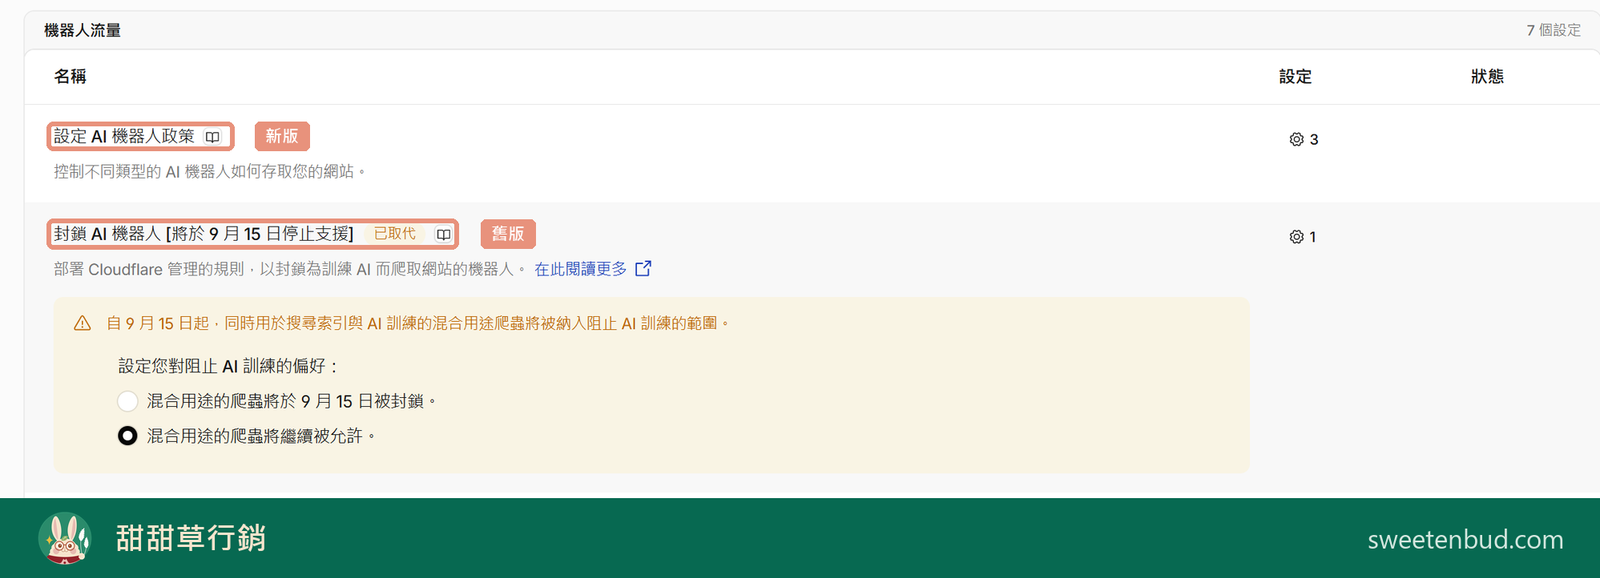
不在 Cloudflare 的話,上面那段跳過。但是要提醒一句:這不代表你就安全了。robots.txt 乾淨只證明第一道關卡沒問題,擋掉爬蟲的還可能是主機商內建的防火牆,或是你裝的安全外掛。
主機商和安全外掛這一層,不必進任何後台就查得到,方法是假裝成爬蟲去敲自己的網站。一樣按 F12 叫出開發者工具,切到 Network 分頁。工具列右邊有一個天線圖示,滑鼠移上去會顯示 Network conditions,點它會在畫面下方開一塊面板;找不到那個圖示的話,走開發者工具右上角的三點選單 → More tools → Network conditions,一樣會開在下方。面板裡找到 User agent 那一區,取消勾選 Use browser default,在旁邊的欄位填 GPTBot/1.0,然後重新整理你的網站。頁面正常出現,就代表這一層沒有擋你。
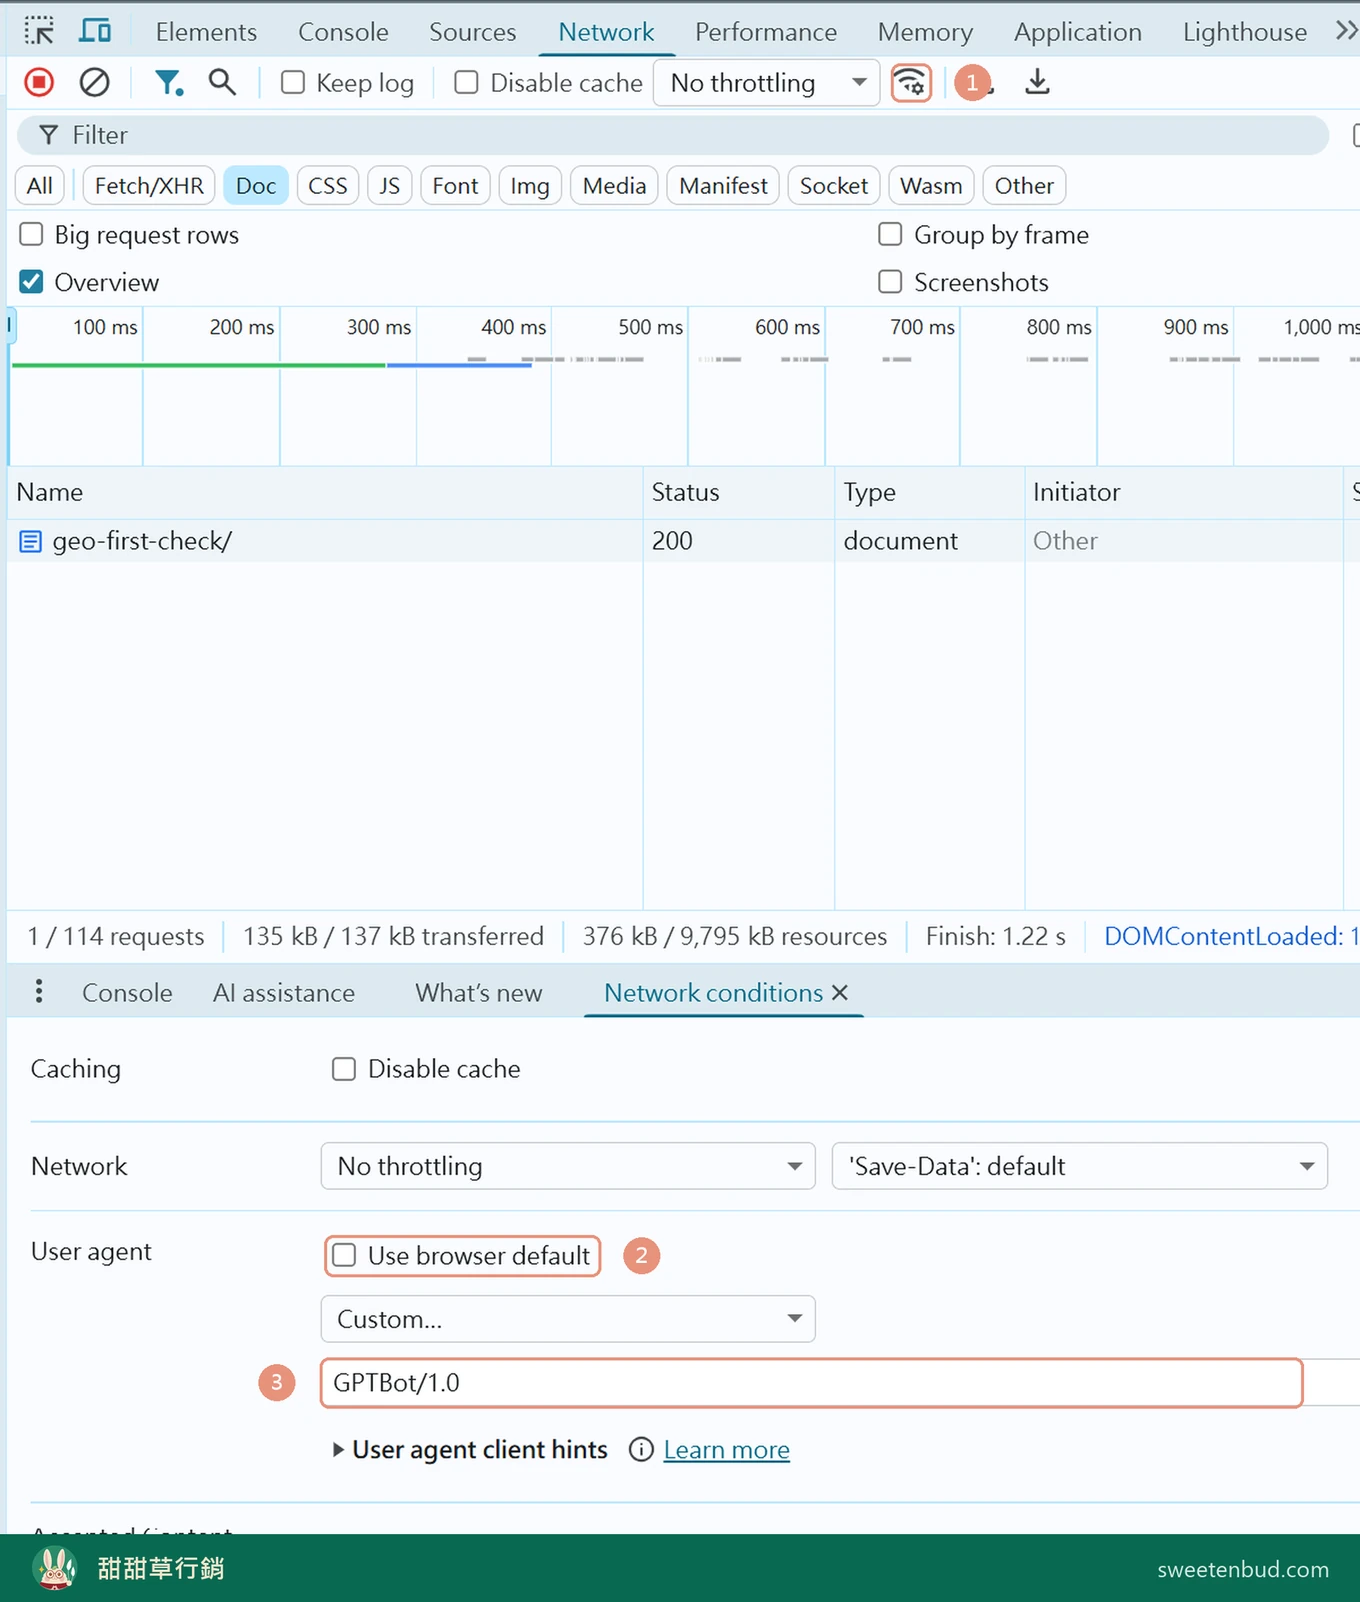
我們驗甜甜草官網用的就是這個方法,換三種爬蟲身分各敲一次,首頁都完整回來。判讀只能單向:頁面正常出現是有效證據;被擋下來則分不出原因,可能是它真的擋 AI 爬蟲,也可能只是識破你在假冒。
三十秒自檢,兩個地方看完就過關
第一關只檢查「機器能不能讀到你」。步驟 2 有 A、B 兩條路,看你的網站掛在誰後面,做一條就好。
1
打開你的網址/robots.txt
找這六隻爬蟲的名字底下,有沒有出現 Disallow: /。整份檔案通常不到二十行。
GPTBot・ClaudeBot・PerplexityBot・OAI-SearchBot・Google-Extended・Applebot-Extended
六隻都沒有被擋 → 過關
2A
掛在 Cloudflare 的看這一頁
先從左側「網域」點進你的網站,再走網路安全 → 設定 → 機器人流量 → 設定 AI 機器人政策。
三格都是「允許」 → 過關
2B
不在 Cloudflare 的這樣測
按 F12 開開發者工具 → Network 分頁 → 工具列的天線圖示(或三點選單 → More tools)打開 Network conditions,把 User agent 的 Use browser default 取消勾選、填入 GPTBot/1.0,然後重新整理你的網站。
頁面正常出現 → 過關
兩步都乾淨就過關了,不需要再做別的。最後提醒一件事:robots.txt 是一份請求,不是一道牆。守規矩的爬蟲會照做,不守規矩的本來就不看,所以這份檔案真正的用處,是別把願意配合的那些擋在門外。
常見問題
擋掉 AI 爬蟲,會影響 Google 搜尋排名嗎?
分兩種情況。用 robots.txt 擋,不會,因為 Googlebot 和 Google-Extended 是兩隻不同的爬蟲,擋後者不影響前者。用 Cloudflare 擋,要看訓練類選哪一個。選「封鎖」會,9 月 15 日起 Cloudflare 會把 Googlebot 整隻擋在門外〔8〕,跟 robots.txt 不同,這是在 Cloudflare 那一層直接擋下,Google 沒有選擇不理它的餘地;選「在含廣告的頁面上封鎖」,只有顯示廣告的那些頁面會擋到 Googlebot,沒掛廣告的網站不受影響。選「Disallow」不影響搜尋排名,但它等於替你關掉 Google-Extended,Gemini 就不再引用你的頁面〔9〕。
開放給 AI 讀,內容會不會被抄走?
已經公開在網路上的內容,本來就處於被讀的狀態。差別只在有沒有標註出處、有沒有連回來。檢索型爬蟲讀完會附上來源連結,那是流量;訓練型爬蟲不會,那才是真的沒有回報。所以要擋就擋得準一點,擋訓練型、留檢索型,別用一個開關把兩邊一起關掉。
llms.txt 要不要做?
不用。Google 官方的生成式 AI 最佳化指南直接把它列在「不需要做的事」裡,明講 Google 搜尋不會使用這類檔案〔6〕。Ahrefs 分析 137,000 個網域,發現 28% 的網站放了 llms.txt,其中 97% 在整個五月收到零次請求〔7〕。花時間做它,不如先確認你的網站有沒有被擋。
GEO 優化的第一關就是這兩個開關,你自己查得完。但是如果你想知道的是整站在 AI 搜尋裡實際被引用幾次、哪幾頁被讀走,那要從 Search Console 的生成式 AI 報表看起,那份報表藏得不淺、判讀也有陷阱,會另外寫一篇。想請我們一起看整個網站的話,SEO/GEO 搜尋優化的服務內容整理在服務頁;有更多問題,也歡迎來信或私訊。
資料來源
- 〔1〕Promptwatch 追蹤數據,轉引自 explainx.ai〈Reddit ChatGPT Citations Drop 86%〉:explainx.ai
- 〔2〕Otterly.ai, The AI Citation Economy Report 2026:otterly.ai
- 〔3〕Cloudflare 開發者文件, Block AI bots:developers.cloudflare.com
- 〔4〕Cloudflare Blog, Content Independence Day:blog.cloudflare.com
- 〔5〕Cloudflare Changelog, AI traffic options(2026-07-01):developers.cloudflare.com
- 〔6〕Google 搜尋中心,針對 Google 搜尋的生成式 AI 功能進行網站最佳化(2026-07-15 更新):developers.google.com
- 〔7〕Ahrefs, We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read:ahrefs.com
- 〔8〕Cloudflare Blog, Have it both ways: stay discoverable in search while disallowing AI training(2026-09-15):blog.cloudflare.com
- 〔9〕Google 搜尋中心,Google 的常見檢索器(Google-Extended 段):developers.google.com
- 〔10〕Cloudflare 開發者文件, Bot Preference Sync:developers.cloudflare.com
